本文来自微信公众号: 生态学时空 ,作者:复旦赵斌,原文标题:《当红线越过蓝线:2026 年,我们该如何读懂中美 AI 的"错位领跑"》
2026年2月第二周,一张全球AI模型调用量榜单上发生了一件小事——也可能是大事:代表中国模型的红线,第一次爬到了代表美国模型的蓝线上方。
那一周,中国大模型周调用量4.12万亿Token,美国是2.94万亿。差距不大,但方向变了。在此之前,蓝线压了红线整整一年。
这件事很快被媒体写成"中国AI反超美国"的信号弹。对普通人来说,这或许只是新闻里一行数字;但对所有用模型写代码、做分析、搭智能体的人,这条交叉线意味着:你每天调用的"发动机",产地正在悄悄换边。可数据真的支持"反超"这个结论吗?我们从能找到的公开数据来进行一下简单的分析,整个分析过程让WorkBuddy代劳了。
本文所有数据来自第三方聚合平台OpenRouter的周度Token调用量测算(按"模型产自哪国"统计),由《每日经济新闻》等媒体持续跟踪。它只是一个观察窗口,不是全量真相——这点我们后面会反复强调。
一、那个交叉点:反超是真的,而且不是昙花一现
先看最抓眼球的一段。2026年初,美国还领先:1月底估算美国约2.82万亿、中国约1.32万亿,差距1.5万亿。短短三周之后,中国冲到4.12、美国不升反降到2.94,差距翻转为中国领先1.18万亿;再到2月下旬,差距拉大到2.46万亿。
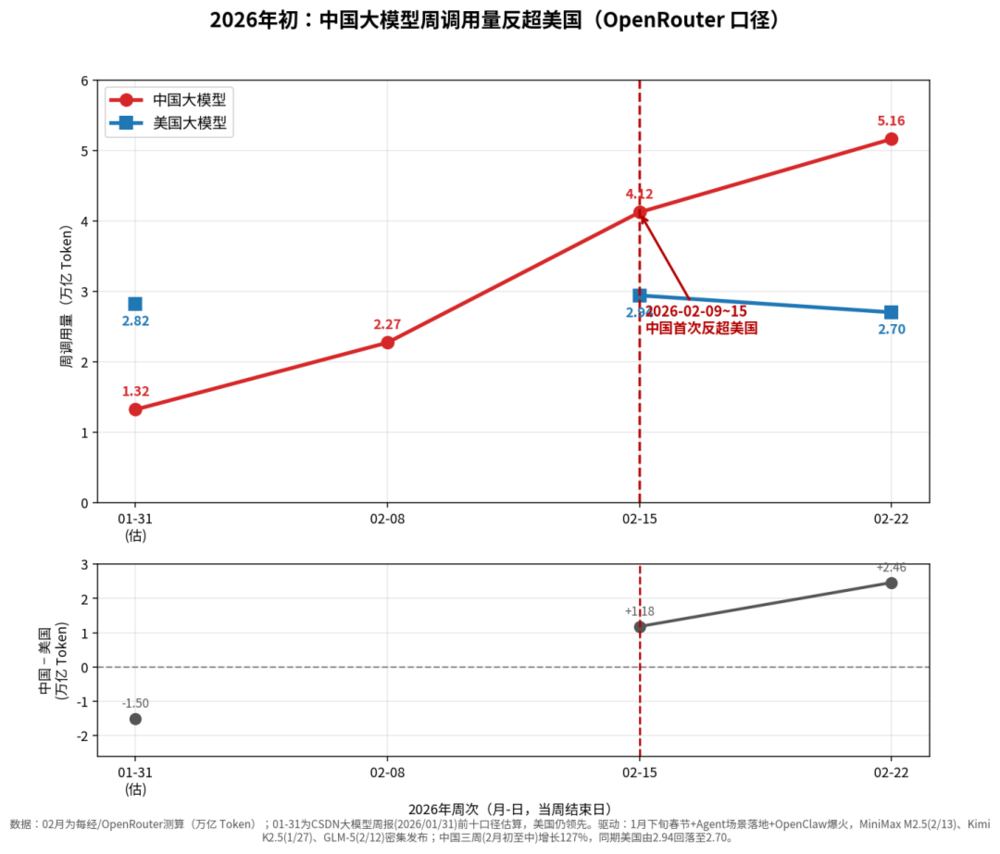
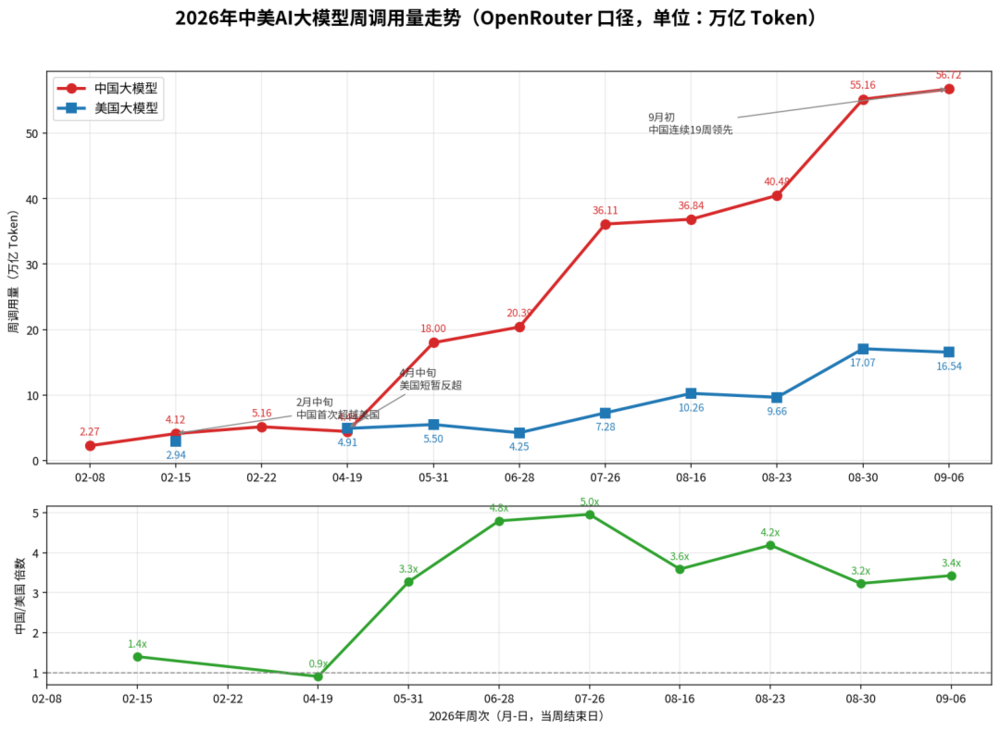
这不是一次偶然波动,反超之后,差距还在持续扩大。到2026年9月初,中国周调用量已达56.72万亿Token,美国16.54万亿,中国连续19周稳居第一,领先倍数约3.4倍。
二、把时间轴拉长:从"追赶"到"领跑"只用了一年
如果只盯2026年,会觉得反转很突兀。但把镜头拉回2025年初,故事就连贯了。2025年3月,中国大模型周调用量还只有约0.4万亿,美国约1.2万亿,美国占据约七成、中国不到两成。此后一年,中国缓慢但稳定地爬升;进入2026年,曲线开始陡峭。
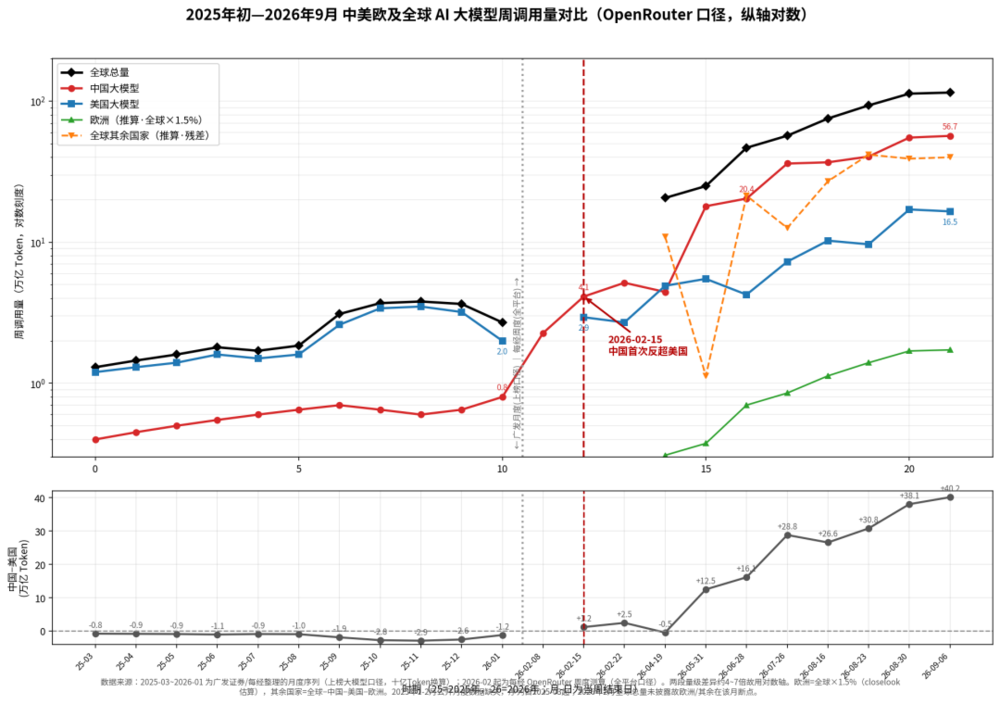
这张图用了对数纵轴:左边(2025年)和右边(2026年起)其实来自两套量级不同的统计口径,不能直接拿左右两端的绝对高度相除比倍数。但它清楚地讲了一件事——中国的斜率明显更陡。从反超周的4.12到9月的56.72,中国约增长了13.8倍;同期美国从2.94到16.54,约5.6倍。全球总量也从4月的20.6万亿涨到9月的115万亿,半年涨了5.6倍。
换句话说:整个市场在爆发,而中国比市场跑得更快。
三、镜头再拉远:全球牌桌上,其实主要坐着两个玩家
把中国、美国、欧洲和"全球其余国家"放在一起看,会发现一个反直觉的事实——欧洲几乎不在牌桌上。
在"模型产自哪国"这个口径下,2026年5月全球Top50里欧洲只剩法国Mistral一款模型,欧洲产地模型约占开放市场的1%~1.5%。所以那条欧洲曲线常年贴着底边。真正有分量的第三方板块,是"全球其余国家"(中东的Falcon、日韩、以及大量长尾开源模型),它波动剧烈——5月被中国爆发压缩到1.1万亿,8月又回升到40万亿。
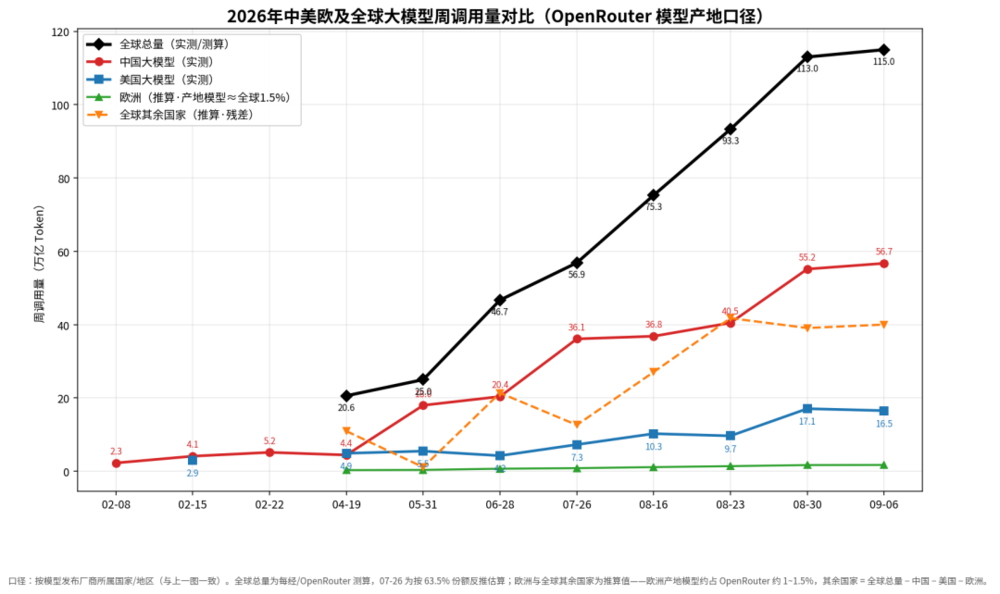
这揭示了一个容易被忽视的格局:今天全球大模型竞争的主轴,就是中美双雄。欧洲在"模型产地"维度上的缺位,本身就是一则值得玩味的产业信号。
四、别急着喊"全面超越"
到这里,情绪很容易滑向"中国赢了"。但是,"调用量领先"和"全面领先",是两件事。我们用一张五维记分卡把竞争格局拆开:
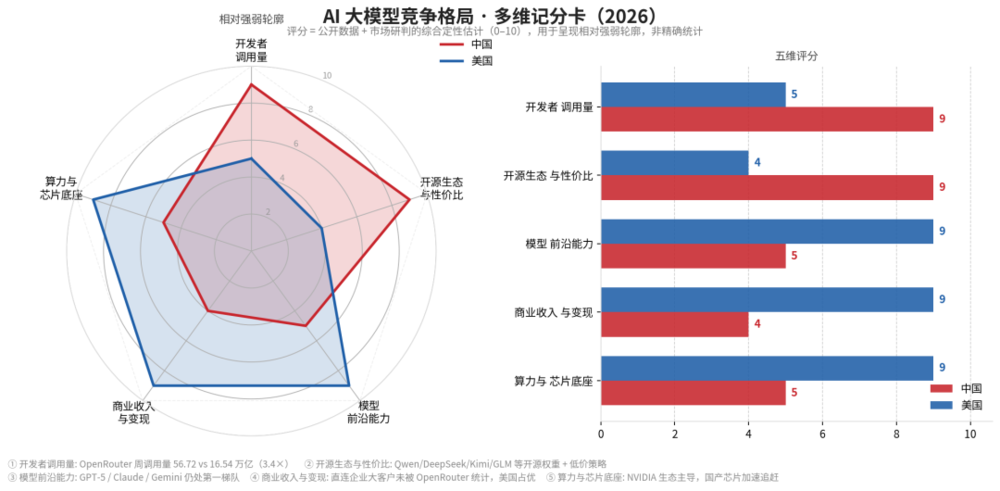
两个形状几乎是互补的:中国赢下的是"用得多、用得便宜"这一侧(调用量、开源性价比),美国守住的却是"做得强、赚得多、底座硬"这一侧(前沿能力、商业收入、算力芯片)。这叫错位领先,不是全面反超。
五、为什么是中国?为什么是现在?
中国调用量的暴涨,背后有三股真实推力:
价格碾压。国产模型API价格普遍是GPT-5/Claude的1/5到1/60。同样一笔预算,买中国模型能烧出数倍Token。一个常被引用的对照:DeepSeek V4 Flash处理一个标准任务约0.02美元,而同档美国模型要价2.75美元——差出一百多倍。便宜,是调用量暴涨最直接的油门。
工程降本。MLA+MoE架构、KV cache优化、峰谷定价、国产芯片,让推理成本比NVIDIA方案低40%~60%。便宜不是补贴出来的,是架构挤出来的。
场景迁移。编程与Agent长任务成为Token消耗主力,而中国开源模型在这类"高性价比长跑"场景里格外吃香。
2026年2月那一波,还叠加了春节后AI渗透加速、MiniMax M2.5/Kimi K2.5/GLM-5密集发布、开源智能体框架爆火等时点因素——所以反超来得又猛又集中。
六、三个必须说清的"但是"
第一,样本有偏。
OpenRouter只占全球Token总消耗的约2%~4%,而且不含OpenAI、Anthropic的直连企业大客户——那恰恰是美国模型占比最高的部分。所以它系统性低估了美国模型的真实体量。更微妙的是,这个平台上美国开发者占47%、中国开发者仅6%,中国模型的高调用量,很多来自海外开发者的主动选择,反映的是开发者市场而非本国消费端。
第二,"跑得快"里有价格灌水。
中国Token价格是美国的几十分之一,同样的"领先倍数"里,有一部分是低价把数字"灌"出来的,不等于"更好用、更被高端市场认可"。
第三,能力差距仍在。
前沿模型(GPT-5、Claude、Gemini)的第一梯队位置没变,商业变现与算力底座仍由美国主导。记分卡里那三个蓝色9分,是实打实的护城河。
结语:我们正进入一个"错位领跑"的时代
把今天的数据拼起来,最诚实的判断是:
在"应用规模+性价比+开源采用"这一层,中国已经从美国手里抢过了领跑位,而且优势在扩大;但在"技术前沿+商业变现+算力底座"这一层,美国仍握着主导权。
这不是谁战胜了谁,而是竞争第一次从"美国单方面领先"变成了"各占一座山头"。对研究者、创业者和政策制定者而言,真正该关心的不是"谁先越过那条线"的瞬间,而是:中国的规模优势,能否转化为能力与收入?美国的前沿优势,又能否扛住来自性价比的侧翼包抄?
红线越过蓝线,只是一个开始。