本文来自微信公众号: 深究科学 ,作者:深究科学
AlphaFold彻底改写了蛋白质结构预测领域,让整个生物医药界对AI抗体设计寄予极高期待。
大量论文、预印本、商业宣传不断渲染:AI可以直接在计算机里“造出”高亲和力治疗性抗体,跳过繁琐的噬菌体、酵母展示筛选,大幅压缩抗体药物研发周期。
近日,一项名为“AIntibody Challenge”(抗体AI挑战赛)的研究结果显示,AI在某些任务上确实能赢,甚至超越传统实验,但远未到“无所不能”的程度,且不同AI模型的能力差异巨大,跨任务泛化能力有限。
8月26日,一篇发表在Nature Biotechnology的重磅工作,AIntibody盲法前瞻性挑战赛,效仿CASP蛋白质结构预测竞赛,集结29家机构,交出511条AI设计抗体序列,全部合成真实验证,用SPR、KinExA测定真实亲和力,搭配5项可开发性实验,完成一次不带滤镜的“AI抗体全真大考”。
这场测试没有推翻AI的价值,但撕下行业泡沫,清晰划出当下AI抗体能做什么、做不到什么。
01
三大任务,直面工业真实场景
挑战赛选用研究最充分的SARS‑CoV‑2 RBD作为抗原,设置三个高度贴合抗体药物管线的任务,全部采用盲测前瞻性设计:参赛团队拿到测序数据集,不知道真实实验结果,提交序列;主办方统一合成全长IgG,标准化实验检测亲和力与成药性,杜绝回顾性分析带来的虚高性能。
任务1:计算机亲和力成熟(In‑silico亲和力成熟)
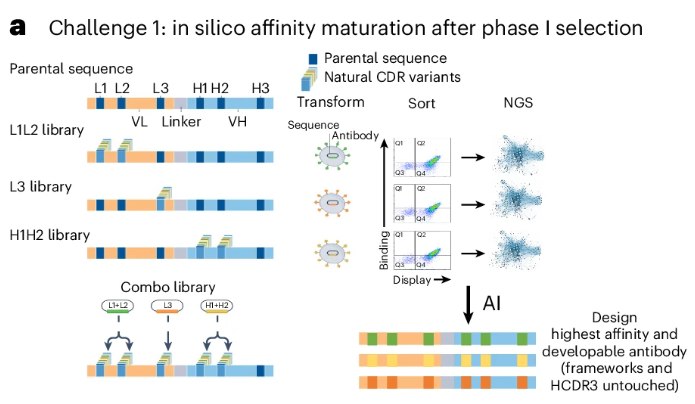
给定一轮筛选后的NGS测序数据,固定HCDR3与框架区,只修改其余CDR,在原有亲本抗体基础上优化亲和力,同时保证可开发性。对应工业界抗体后期亲和力优化环节。
任务2:HCDR3簇内亲和力排序
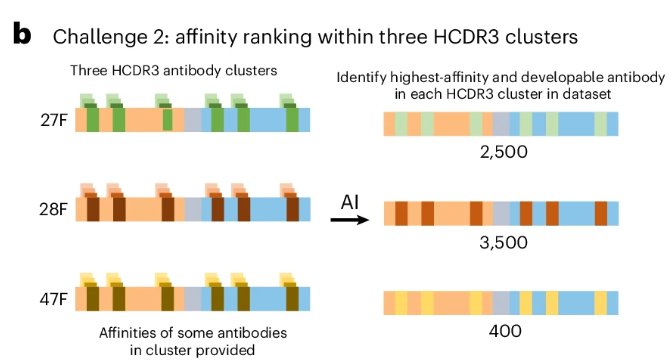
数据集被划分成3个HCDR3序列簇(27F、28F、47F),团队需要从数千条序列里,预测每个簇内亲和力最高、成药性合格的抗体。对应高通量测序后,从海量克隆里挑出最优候选的hit‑expansion流程。
任务3:库外全新CDR设计
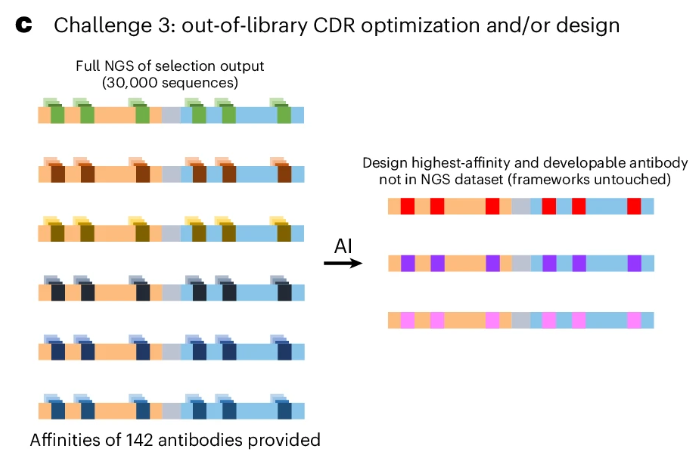
基于全部测序数据集,生成数据库中不存在的全新CDR组合,框架保持不变,追求高亲和力与良好成药性,代表最有想象力的“从头AI抗体设计”。
评价标准不只有亲和力KD,还引入药物开发至关重要的可开发性(developability):热稳定性Tm、聚集温度Tagg、疏水性HIC、多特异性BVP、自相互作用AC‑SINS五项实验,每条抗体打分,总分≤3才算具备药物开发潜力,避免“亲和力爆表,但一做药就聚集、多特异、无法生产”的纸上分子。
02
成绩单——有高光,也有不足
任务1亲和力成熟:AI真正闪光的地方
在已有亲本抗体、充足测序多样性数据加持下,AI交出了全场最好的答卷。Aureka的结构感知模型拿到95 pM的抗体,和亲本相比亲和力提升约2000倍,与实验筛选得到的最优抗体(113 pM)统计学上几乎持平。
有意思的是,不用复杂AI的简单统计共识法(ProBioGen)也拿到第三名540 pM的优异结果,仅仅对测序库做位置频率统计,不靠深度学习就超过绝大多数AI算法。
整体统计:166条提交序列中,63%同时做到结合抗原且可开发;3%拿到亚纳摩尔亲和力,0.6%实现小于100 pM超高亲和力。
这证明:当拥有充足真实筛选测序数据,针对已有抗体做局部CDR优化,AI确实可以缩短2‑3周实验周期,具备实实在在工业价值。但也存在问题:部分团队一条合格可开发结合抗体都没有,模型之间差距巨大。
任务2簇内预测:大部分AI,干不过随机挑选克隆
这是全文最颠覆认知的结论。
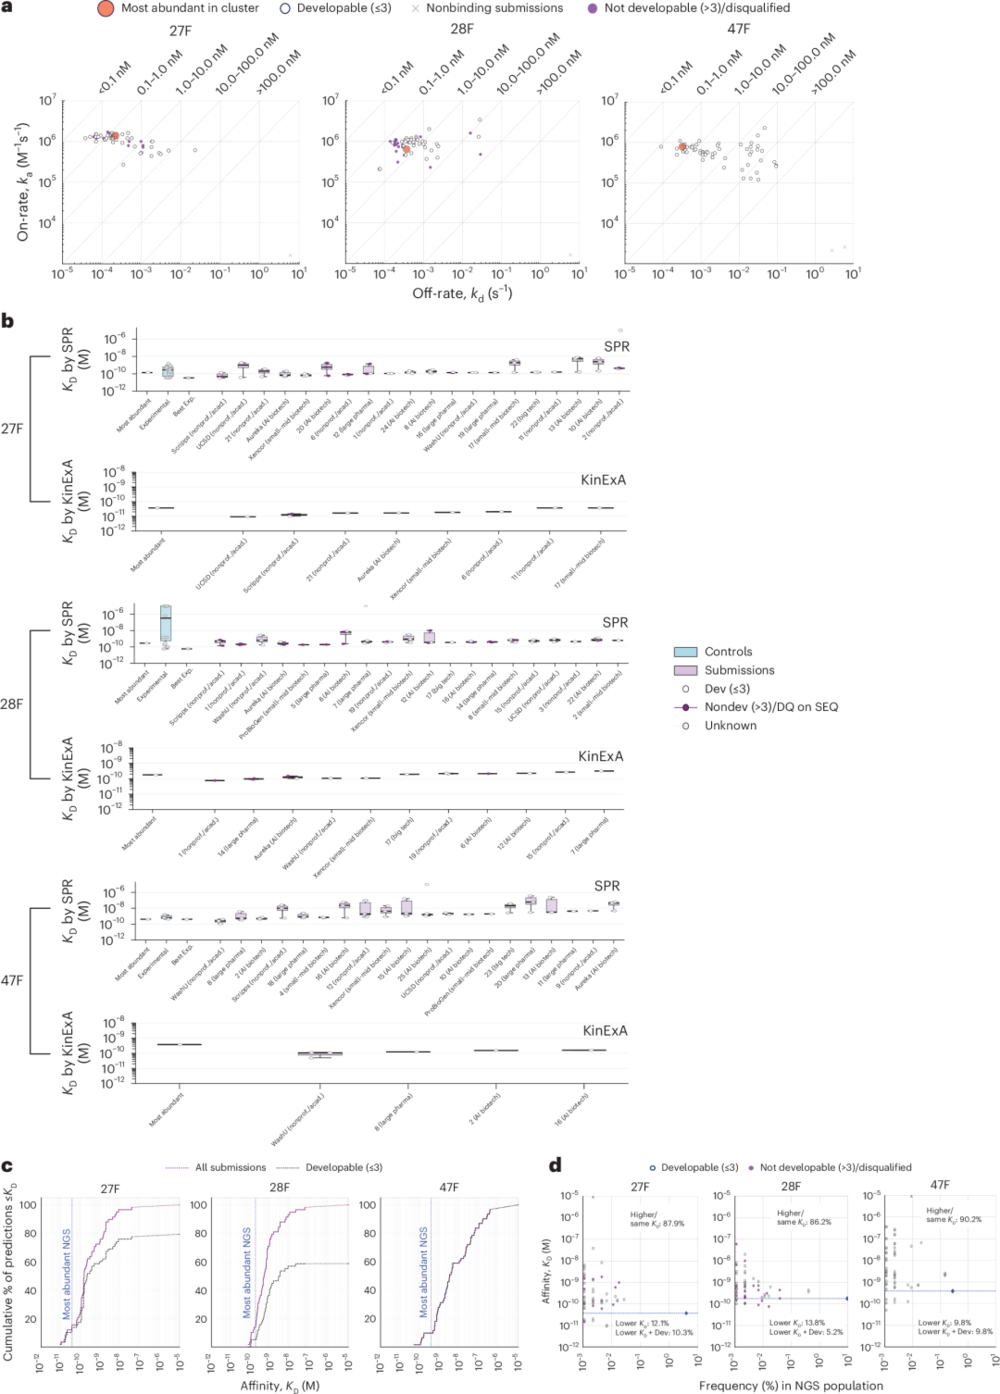
研究基线显示,从HCDR3簇里随机挑选克隆,就有39%概率比丰度最高的簇对照亲和力更好。
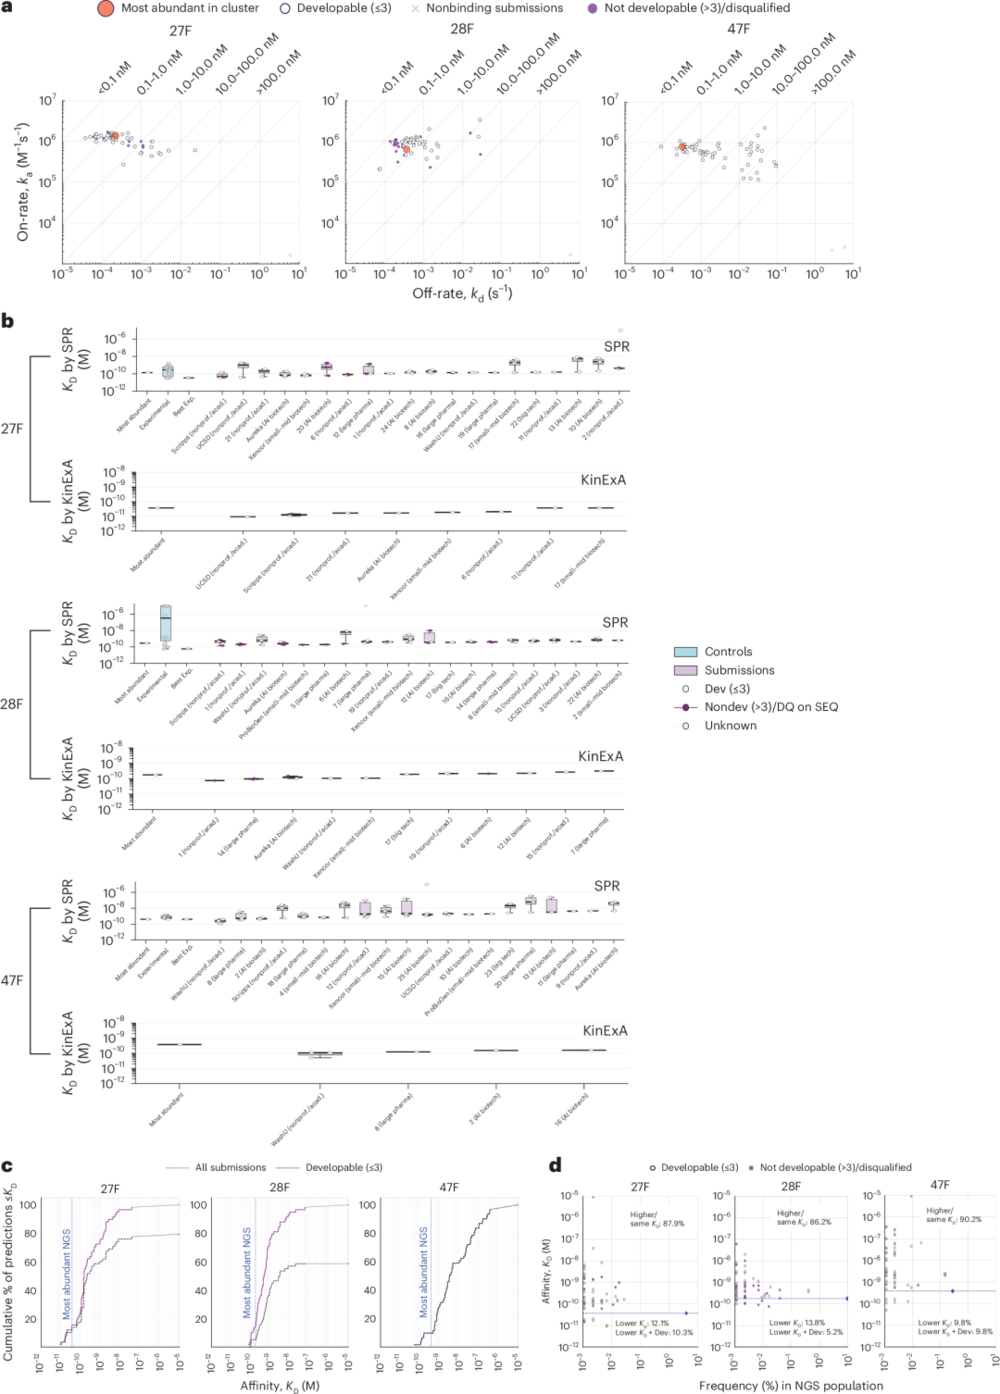
但绝大多数AI模型的表现低于这个随机基线:AI提交序列中,只有9.8%‑13.8%优于簇对照。全26支队伍里,仅有华盛顿大学WashU一支队伍超过随机基线。即便任务拿到部分真实亲和力标签,大部分AI依然无法从海量序列中精准定位高亲和力克隆。
同时,模型没有跨集群泛化能力:同一个赢算法,在A簇夺冠,换到B簇就表现平庸。
这里暴露行业巨大痛点:亲和力预测依然是整个领域最大短板。即便有测序、部分亲和力标签,想直接从序列预测真实结合强弱,现有模型依然非常吃力,远达不到工业期待。另外HCDR3深刻决定可开发性,同一个算法,在47F簇全部抗体成药性优秀,换到28F簇大量分子出现聚集、多特异性问题,算法很难预判这些生物物理风险。
任务3库外全新CDR设计:能造出超级分子,但“药化陷阱”重重
Xencor的蛋白语言模型产出全场最强2.9 pM的超紧密结合抗体。然而,这支冠军抗体在疏水性HIC色谱柱无法有效洗脱——按照药物开发标准属于严重致命缺陷。挑战赛的加权计分规则允许单项失败被其他指标抵消,才让它拿到第一名,但现实药物开发中会被直接淘汰。
全局结果:168条提交序列,接近三分之一(30.4%)完全不结合抗原;即便结合,高亲和力分子往往伴随成药性缺陷。很多获胜设计并非天马行空全新HCDR3,只是在数据集已有的HCDR3基础上,对周边CDR做少量保守突变,真正意义上完全跳出原有文库的创新很少。
这也意味着,当下生成式AI更擅长“微调或改良”,而不是凭空创造。
03
不存在“通杀一切”的万能模型
参赛方法被分为四大类:统计启发式基线、传统机器学习、蛋白语言模型PLM(Transformer/抗体大模型)、结构感知方法(AlphaFold3、ProteinMPNN等)。
挑战赛得出一个非常务实的结论:没有一类算法在全部任务通吃,最优方案高度依赖任务类型。
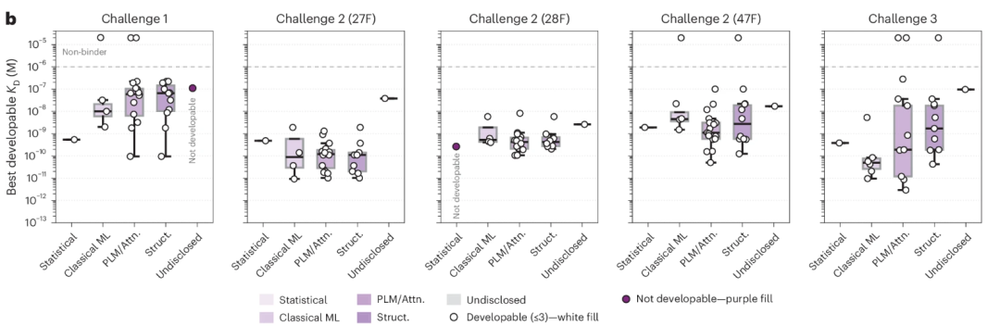
亲和力成熟任务:结构感知+蛋白语言模型组合夺冠,简单统计基线也可以打出高分;
簇内预测任务:冠军来自传统高斯过程回归、定制Transformer、PLM,不同簇胜出方法完全不同,没有一类技术占绝对上风;
库外全新CDR生成:蛋白语言模型表现相对最好。
同一个团队的同一套算法,往往是“一个任务封神,另一个任务拉胯”,跨任务泛化能力普遍很差。
论文提出务实思路,工业管线不要迷信“一个模型解决全部问题”,应当采用组合策略:
库内亲和力成熟:可以使用统计共识+AI模型并行;
簇内候选筛选:不能完全依赖AI预测,保留随机挑选作为重要基线;
全新序列生成:优先蛋白语言模型,但必须严格后续实验验证成药性。
同时,研究发现,可开发性很难靠计算精准预判。大量AI给出高亲和力序列,会出现多特异性、聚集风险;计算打分不能可靠替代五项湿实验检测。
AIntibody最大价值,是给整个领域敲了一记警钟:很多论文的亮眼效果,来自回顾性数据集的“便利光环”,一旦切换成盲法、前瞻性、全部合成实测,性能会大幅缩水。
在合适场景,也就是已有结合分子、拥有高质量测序数据集,做局部CDR亲和力优化,AI确实可以产出媲美实验筛选的候选,节约实验时间成本。
但现阶段AI不能完全替代湿实验,它更适合作为“高效候选生成器”,产出一批候选序列,仍然必须经过完整体外实验验证亲和力与成药性。
04
下一代AIntibody的方向
这项研究只是第一代基准,作者公布全部测序、亲和力、成药性原始数据,全部获胜团队开源代码,供全球科研人员测试迭代自己的算法。
下一代AIntibody挑战赛计划:
取消大量预先提供的亲和力标签,模拟早期真实抗体发现,仅输入测序数据;
修改评分规则,设置硬性成药性一票否决,杜绝“高亲和力抵消成药性缺陷”;
拓展更多抗原靶点,摆脱本次仅使用RBD的局限,检验模型跨抗原泛化能力。
AIntibody的启示,不止局限抗体AI,对整个生成生物学都有借鉴意义:
仿真、回顾性测试只能作为前期筛选;真正的金标准永远是盲法前瞻性+全部实验验证。
AI抗体设计不是“已经实现革命”,而是站在转折点。它已经拿到入场券,在部分场景可以赋能药物研发,但距离可以脱离实验、“输入抗原直接输出临床级抗体”的终极理想,仍隔着巨大的生物现实鸿沟。
参考文献
Erasmus M F,et al.A blinded,prospective benchmark of in silico antibody discovery anchored to experimental affinity and developability.Nature Biotechnology,2026,doi:10.1038/s41587‑026‑03238‑6